26 de septiembre de 2026
PeerDAS: el gato ninja no descarga el bloque entero
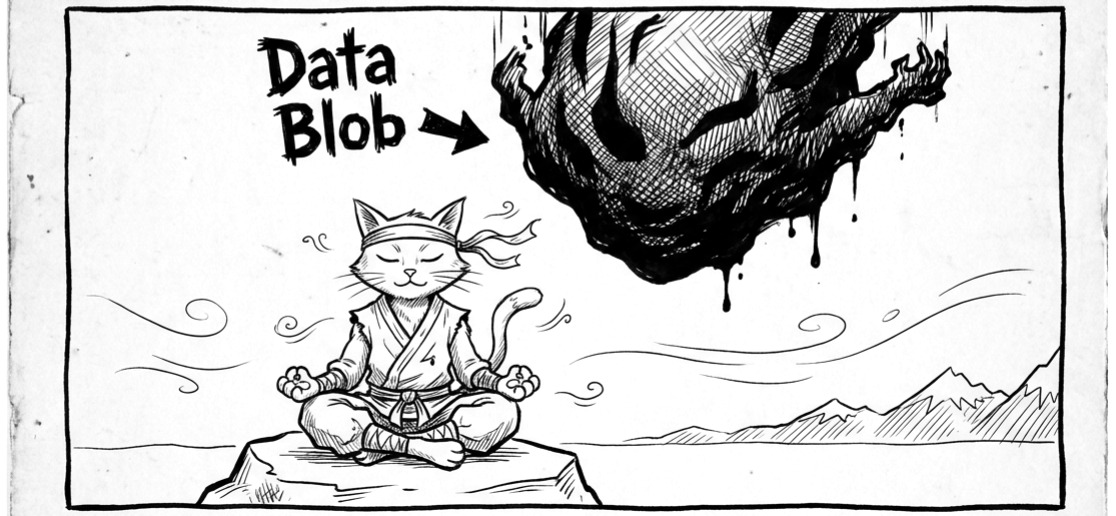
El 26 de septiembre de 2026, Vitalik Buterin escribió algo que se leyó rápido y se discutió poco:
It’s an underappreciated triumph of Ethereum client developers that PeerDAS has now been running for nearly a year with basically no problems. PeerDAS was a complex task: it’s the first large-scale instance of a blockchain that achieves consensus on the availability of data without needing any single node to download the entire block. Decentralized consensus without replication. And yet, it worked.
Dos afirmaciones en un tweet: que llevaba casi un año, y que no había tenido problemas. Las dos son ciertas, y las dos esconden algo más interesante de lo que dicen. Porque lo que aguantó no fue la matemática —esa ya estaba escrita, revisada y publicada— y lo que se rompió en el camino no fue PeerDAS. La historia de este año es la de un protocolo que le sacó un peso de encima a diez mil nodos y se lo dejó entero sobre uno solo.
El peso de los datos
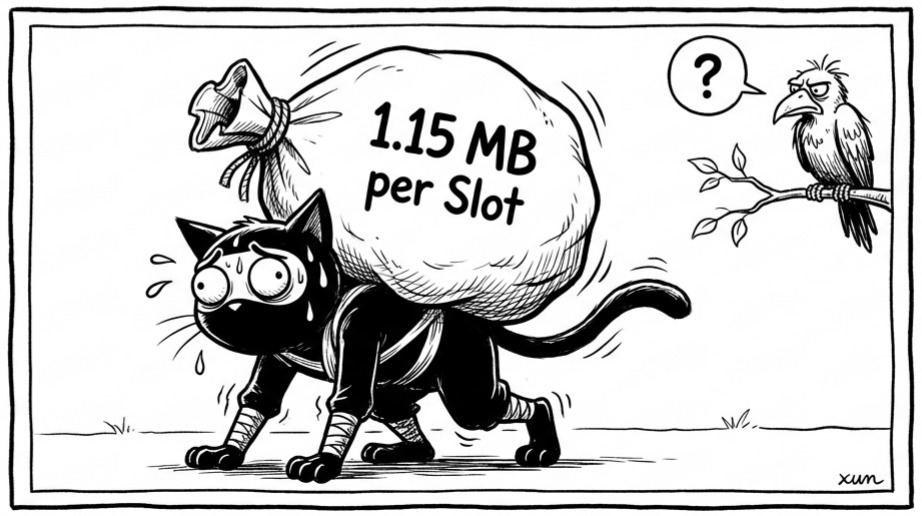
Empecemos por el problema, porque sin el problema el truco no se entiende. Las rollups mandan datos a Ethereum en paquetes llamados blobs, de 128 KiB cada uno. Cada 12 segundos, un bloque nuevo. Con los parámetros previos a Fusaka —los de Pectra, 6 blobs de objetivo y 9 de techo— eso ya era más de 1 MB por slot cuando la red usaba todo el espacio disponible.
Antes de PeerDAS, cada nodo descargaba todo. Y ahí está la trampa: la descentralización no se pierde por un ataque, se pierde por aritmética. Si el requisito mínimo para verificar la cadena crece sin techo, el conjunto de gente capaz de verificar la cadena se encoge sin techo. Obligar a cada nodo a cargar con todo es la forma más elegante de matar la descentralización: no la prohíbe, la hace cara.
La apuesta: dividir el trabajo
PeerDAS (Peer Data Availability Sampling) es la respuesta, y llegó a mainnet con Fusaka el 3 de diciembre de 2025, en el slot 13.164.544. La idea es una sola frase: los nodos dejan de descargar el archivo entero y garantizan matemáticamente que los datos existen cargando una fracción microscópica de ellos.
Conviene decirlo con precisión, porque suena a magia: no es que los nodos confíen en alguien que sí tiene todo. Es que pueden probar que el todo está ahí sin haberlo visto. La división descentralizada del trabajo, aplicada a la disponibilidad de datos.
Paso 1: la rebanada holográfica
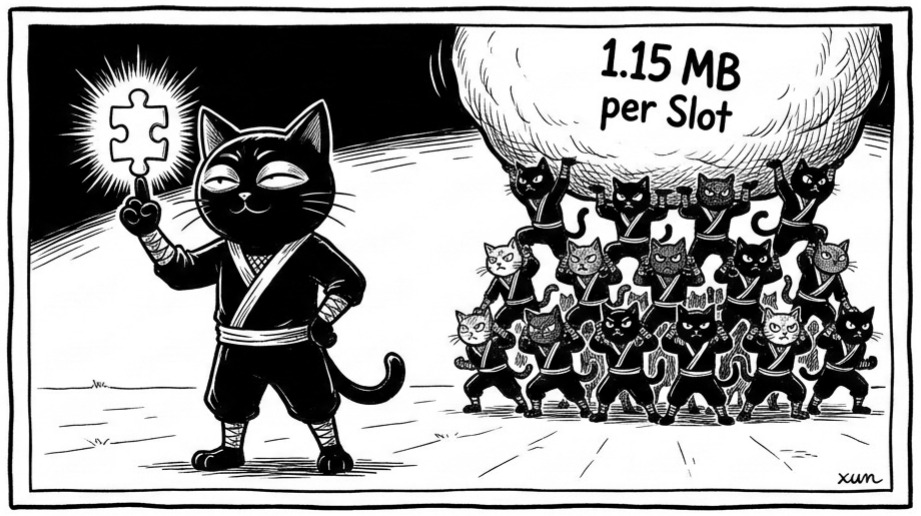
Antes de repartir nada, el bloque se estira matemáticamente con codificación Reed-Solomon: los datos se duplican (extensión 2×). Y ahí aparece el truco: si tenés cualquier 50% de los pedazos dispersos, podés reconstruir el 100% del dato original.
No es una copia de respaldo. Es un holograma: cada fragmento contiene información sobre el todo, y por eso no hace falta que ninguno esté completo.
Paso 2: 128 columnas
El blob extendido no se reparte al azar. Se estructura en exactamente 128 columnas verticales, y esas columnas pasan a ser la nueva unidad fundacional de datos de la red. Todo lo que sigue —custodia, muestreo, subredes— se piensa en columnas.
Paso 3: sintonizar una frecuencia
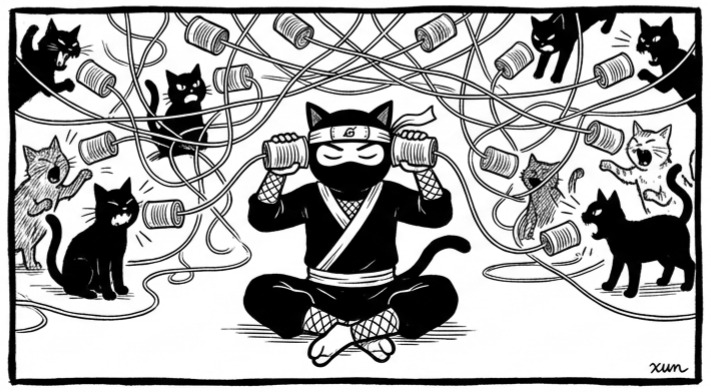
La red se divide en subredes de columna, y un nodo hogar no escucha la red entera. Se suscribe a un subconjunto aleatorio y permanente (ocho de las 128 columnas, por ejemplo) que se deriva de su propio Node ID.
Que sea permanente importa más de lo que parece: la custodia no es una elección que el nodo hace cada slot, es una posición que le toca por identidad. Nadie puede elegir custodiar solo lo que le conviene.
Paso 4: la cata probabilística
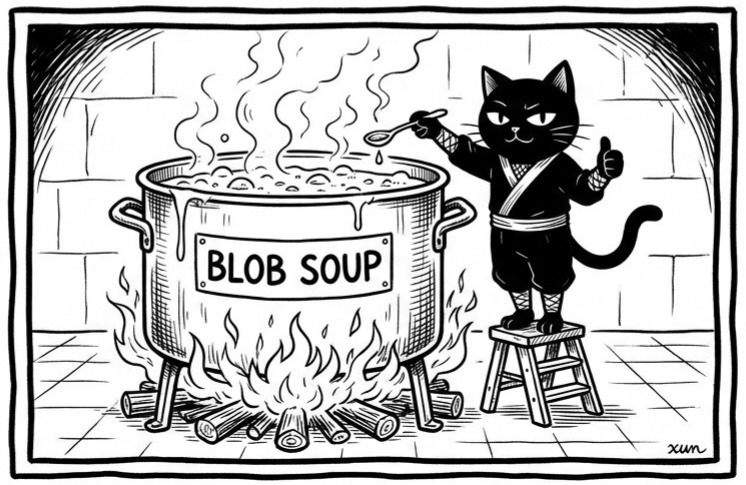
Acá está el salto epistémico de todo el diseño. No hace falta tomarse cincuenta litros de sopa para saber si está salada.
Los nodos piden muestras al azar, diminutas, de columnas ajenas. Y con haber probado unas pocas gotas al azar, obtienen certeza estadística de que el blob entero está disponible. La seguridad no viene de la cobertura total, viene de que una mentira tendría que sobrevivir simultáneamente a cada muestra aleatoria que cualquier nodo decida pedir. Es una apuesta —una apuesta muy buena— a la probabilidad como fundamento.
Paso 5: el sello criptográfico de la verdad
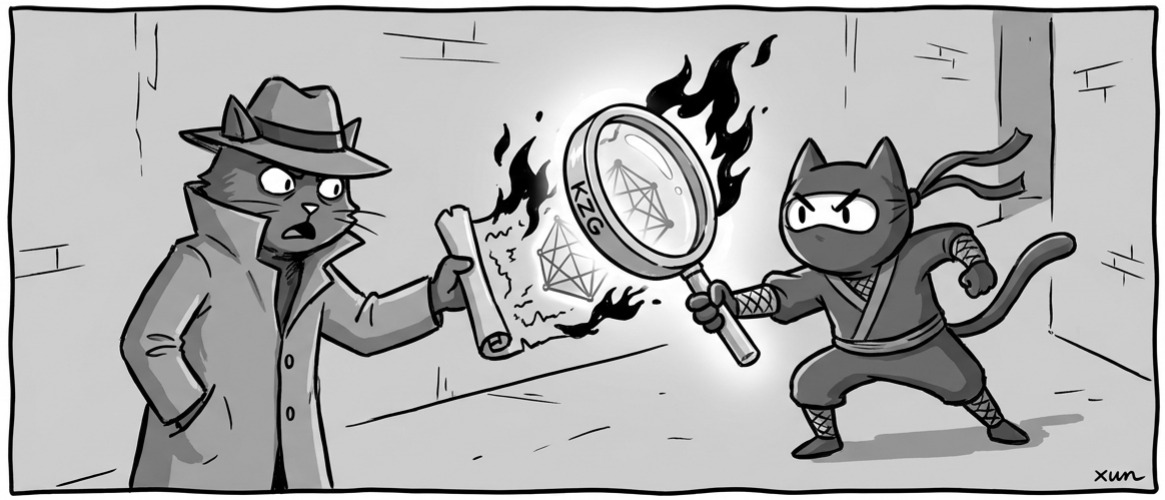
Y acá es donde el muestreo se vuelve confiable y no ingenuo: las pruebas KZG de celda permiten que cualquier nodo verifique al instante la muestra de un par, cotejándola contra el compromiso matemático del bloque principal. El nodo nunca tiene que confiar en el par que le sirve los datos.
Muestreo sin verificación es fe. Muestreo con verificación es prueba. La diferencia entre las dos es un compromiso criptográfico que ata cada celda al bloque, y permite aceptar datos de un enemigo.
La red de seguridad de los supernodos
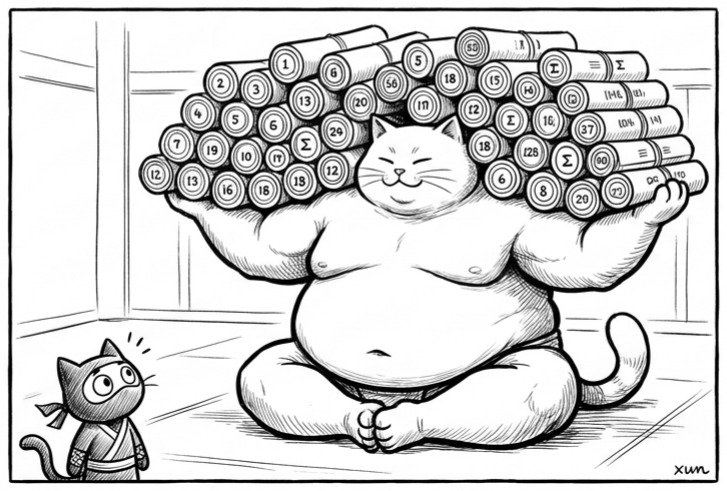
Queda un hueco y conviene nombrarlo, porque el titular de “consenso descentralizado sin replicación” lo tapa. Mientras los nodos hogar muestrean una fracción, los validadores con 4.096 ETH o más actúan como supernodos: custodian las 128 columnas completas y son la columna vertebral que garantiza que la reconstrucción siempre sea posible.
Traducido: los nodos chicos muestrean, los grandes archivan. PeerDAS no eliminó al nodo completo —lo volvió opcional para casi todos y obligatorio para unos pocos, y esos pocos son los que más capital tienen. Es un intercambio razonable, y es infinitamente mejor que el mundo anterior, donde la obligación era de todos. Pero es un intercambio, no un regalo.
Lo que PeerDAS no shardea
Acá está la parte que el anuncio no dice, y es la que convierte este año en un comienzo y no en un final.
La verificación de la Capa de Consenso quedó shardeada horizontalmente: eso es PeerDAS. Pero el blobpool de la Capa de Ejecución no lo está —los nodos todavía descargan los blobs completos cuando se envían— y, sobre todo, el proponente del bloque sigue siendo un solo nodo que debe:
- extender el blob con la codificación Reed-Solomon,
- calcular todas las pruebas KZG de celda,
- y repartir las 128 columnas por la red,
todo antes del deadline de attestation, cuatro segundos después del inicio del slot. Si no llega, pierde el bloque o se lo reorganizan.
El trabajo de verificar se repartió entre miles. El trabajo de publicar sigue entero sobre uno. El cuello de botella no desapareció: se mudó del ancho de banda a la ruta crítica del proponente.
Y esto deja de ser teoría cuando se mide. Un análisis de Chainbound encontró que más blobs por bloque correlacionan con peor latencia de validación de bloque+blob, peor tasa de attestation y más orphans, y sacó una conclusión incómoda y precisa: en un PBS que compite por latencia, eso puede imponer un techo de blobs artificial, por debajo del límite que el protocolo toleraría. En el devnet de 60 nodos que corrió Optimism se llegó a unos 50 blobs por bloque y ahí apareció la grieta: retrasos de consenso acumulados, descarga de blobs poco confiable y algunos supernodos empezando a fallar.
No es que PeerDAS no escale. Es que escaló la mitad del problema, y la otra mitad —ejecución, propuesta, mempool— quedó esperando su propio PeerDAS.
El embotellamiento que queda
El segundo frente abierto es menos visible y más urgente: el blobpool, el mempool de blobs de la Capa de Ejecución. Cuando una rollup envía un blob, los nodos todavía lo descargan completo antes de que quede disponible en la red. La verificación de disponibilidad ya es horizontal, pero la propagación de la entrada sigue siendo vertical, y eso abre una vulnerabilidad de denegación de servicio muy concreta: se puede inundar la red de blobs basura y hacer que cada nodo pague el costo de bajarlos todos, uno por uno.
La solución tiene nombre —vertical sharding— y todavía no está. PeerDAS le resolvió el problema a la salida; la entrada sigue esperando.
El dial que no necesita hard fork
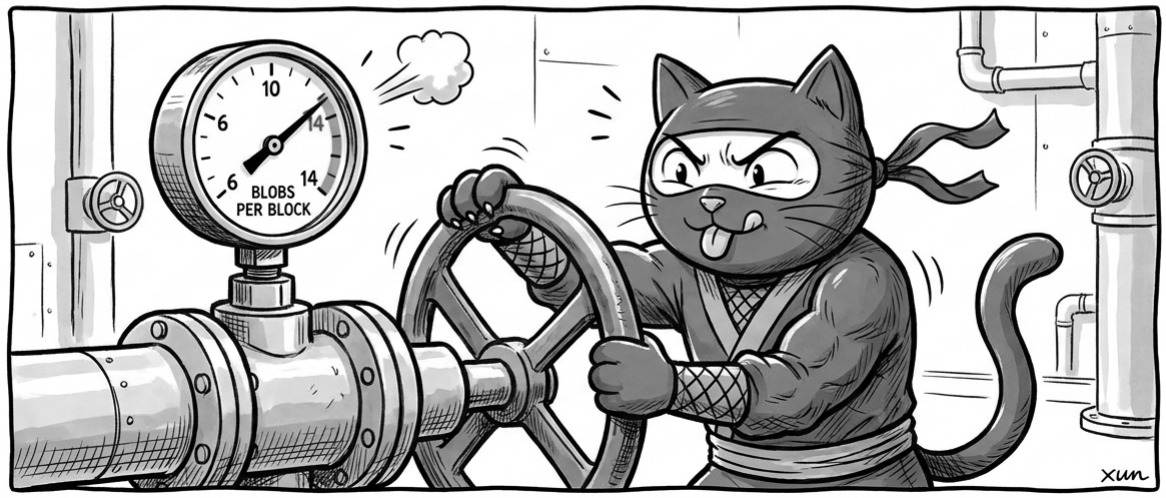
La segunda jugada subestimada es de diseño, y es casi más elegante que el muestreo: PeerDAS no se encendió a máxima capacidad. Se encendió a una capacidad, y después se la fue subiendo con BPO forks —Blob Parameter Only (EIP-7892)—, que no son hard forks coordinados ni actualizaciones de cliente: son parámetros.
| Upgrade | Blobs objetivo | Blobs máximo |
|---|---|---|
| Cancun | 3 | 6 |
| Pectra (Prague) | 6 | 9 |
| Fusaka + BPO1 | 10 | 15 |
| BPO2 (7/1/2026) | 14 | 21 |
| BPO3 (esbozado) | 21 | 32 |
Del día uno de Fusaka a hoy, el bloque pasó de 10 a 14 blobs de objetivo y de 15 a 21 de techo: 1,75 MiB objetivo y 2,6 MiB de máximo cada 12 segundos. Y todo eso sin que la red tenga que volver a coordinarse, porque se separó la capacidad —la parte difícil, que se shippea una sola vez— de la cantidad —la parte fácil, que se gira como una perilla—. Las palabras de un EIP lo dicen con una honestidad que no se ve seguido: los BPO “no están motivados por demanda demostrada, sino por la necesidad de evaluar los límites del sistema de forma controlada”.
Es un laboratorio a escala de mainnet, con la mano en la válvula.
Un año sin problemas, casi
Ahora la parte donde el titular de Vitalik merece un ajuste menor. No son casi doce meses: son nueve meses y veintitrés días. En ese tiempo, PeerDAS como protocolo no falló ni una vez. Pero la red tuvo sus días.
Días después de Fusaka, un bug en Prysm v7.0.0 —un cliente de consenso— generaba estados viejos de más al procesar attestations atrasadas y dejaba nodos fuera de combate: en el pico, alrededor de un cuarto de las validaciones de mainnet dejó de participar y la red estuvo cerca de perder finality. Meses más tarde, un livelock de sincronización en Lighthouse en la testnet Hoodi dejaba la cabeza de la cadena quieta cada día y medio, con el rate-limiter del propio nodo bloqueando todos los pedidos de columnas.
Ninguno de los dos fue un fallo de PeerDAS. Y ahí está el punto, que es exactamente el que Vitalik está elogiando: un protocolo nuevo que atraviesa su primer año mientras un cliente se rompe y la red lo absorbe no está demostrando matemática. Está demostrando aislamiento de fallas.
La diversidad de clientes es a los equipos de desarrollo lo que PeerDAS es a los nodos: que ninguno cargue con todo, para que el que se cae no se lleve la red puesta. Es el mismo principio aplicado dos veces —en la capa técnica y en la capa social— y en la segunda es donde el año se ganó de verdad. Un protocolo se escribe en un EIP; un ecosistema que aguanta un protocolo nuevo se construye durante años, y no se ve en ninguna tabla de métricas.
El premio
La consecuencia económica es la que ya se ve venir: si la disponibilidad de datos deja de ser el recurso escaso, la oferta de blockspace se multiplica y las comisiones de las L2 caen por órdenes de magnitud. Ethereum no compite por ser la cadena más rápida; compite por ser la capa de liquidación más barata y más verificable. Ahí es donde este año se convierte en la base de todo lo demás.
Falta lo grande
Los parámetros que hoy corre la red son los de un muestreo 1D: una sola dimensión de codificación. El destino es el danksharding completo, con codificación en 2D —extender no solo las filas sino también las columnas— y 64 blobs o más por bloque.
La diferencia no es cosmética. En 2D, un nodo necesita muestrear muchos menos datos para alcanzar el mismo nivel de certeza, y el trabajo del proponente se reparte de verdad. PeerDAS no es el final de la escalabilidad: es la prueba de que la matemática funciona en producción, y esa prueba es lo único que faltaba para autorizar el resto.
Data Available
Mirá la última lámina de la serie: el gato suelta el pergamino, la red respira, y la viñeta entera se reduce a dos palabras que no son un grito de victoria sino una condición: Data Available.
Vale la pena detenerse en qué clase de certeza compra PeerDAS. No es la certeza de haber visto todo. Es la certeza de que, si algo faltara, la mentira tendría que sobrevivir simultáneamente a cada muestra al azar que cualquier nodo decida pedir. Es una certeza probabilística, y por eso mismo es barata de obtener y barata de repetir en cada slot.
Y esto —y no otra cosa— es el puente con lo que venimos escribiendo. Ayer contamos cómo Ğ1 decide quién es una persona con una tela de confianza: no hay registro central, hay cinco firmas de otros miembros, y esas firmas vencen y hay que renovarlas. Tampoco Ğ1 pide la verdad completa: pide una verificación local, suficiente y renovable.
Son el mismo movimiento epistémico en dos capas distintas. PeerDAS: muestreá unas celdas contra un compromiso KZG. Ğ1: verificá unas firmas que expiran. En ninguno de los dos casos la confianza se guarda: se produce, y se vuelve a producir. Y en ninguno de los dos hace falta tenerlo todo para saber que está bien.
El siglo pasado nos enseñó lo contrario: para confiar había que tener la copia, el registro, el notario, el respaldo completo. Los compromisos criptográficos rompieron esa ecuación. Una prueba no es un archivo: no ocupa lugar, no se pierde, se puede rehacer en cualquier momento, y no le entrega a nadie las llaves de tu casa.
Por eso este año de PeerDAS es, además de un triunfo de ingeniería, una lección sobre qué es la libertad: no depender de quien tiene la copia. Durante una década, la respuesta a “¿está todo disponible?” fue “descargá el bloque entero y averigualo vos”. Hoy la respuesta es “muestreá unas celdas y sabé”. Es más rápido, es más barato, y es, sobre todo, más antiguo: es la forma en que siempre funcionó la confianza entre personas que no necesitan tener toda la verdad para saber que la otra está ahí.